Lekcja 02
Onboarding
Na nagraniu i zrzutach widać stare nazwy, a czasem starszy przebieg. Dziś komendy zaczynają się od /b:, więc trzymaj się tekstu poniżej.Cel tej lekcji: przejść cały onboarding krok po kroku (onboarding = pierwsza konfiguracja bazy) na konkretnym przykładzie. Po lekcji masz wygenerowaną schema (CLAUDE.md - plik zasad Twojej bazy), foldery tematów i puste, ale gotowe indeksy - i wiesz dokładnie, co dzieje się pod spodem.
Prowadzę Cię przez realny przebieg (screeny z prawdziwej sesji): Anna stawia bazę „Baza Anny” po polsku, na tematach AI, BUSINESS, HEALTH. Twoje odpowiedzi będą inne - proces jest ten sam.
Warunek startu
Onboarding odpalasz raz, na świeżym klonie. Kreator rozpoznaje świeży klon po obecności pliku CLAUDE.template.md w repo.
Najpierw zainstaluj zależność z lekcji 1, czyli PyYAML (bibliotekę Pythona, której wymaga skrypt budujący indeksy): pip install -r requirements.txt. Możesz też napisać asystentowi „zainstaluj zależności z requirements.txt”. Potem otwórz folder w Claude Code i wpisz:
/b:onboard
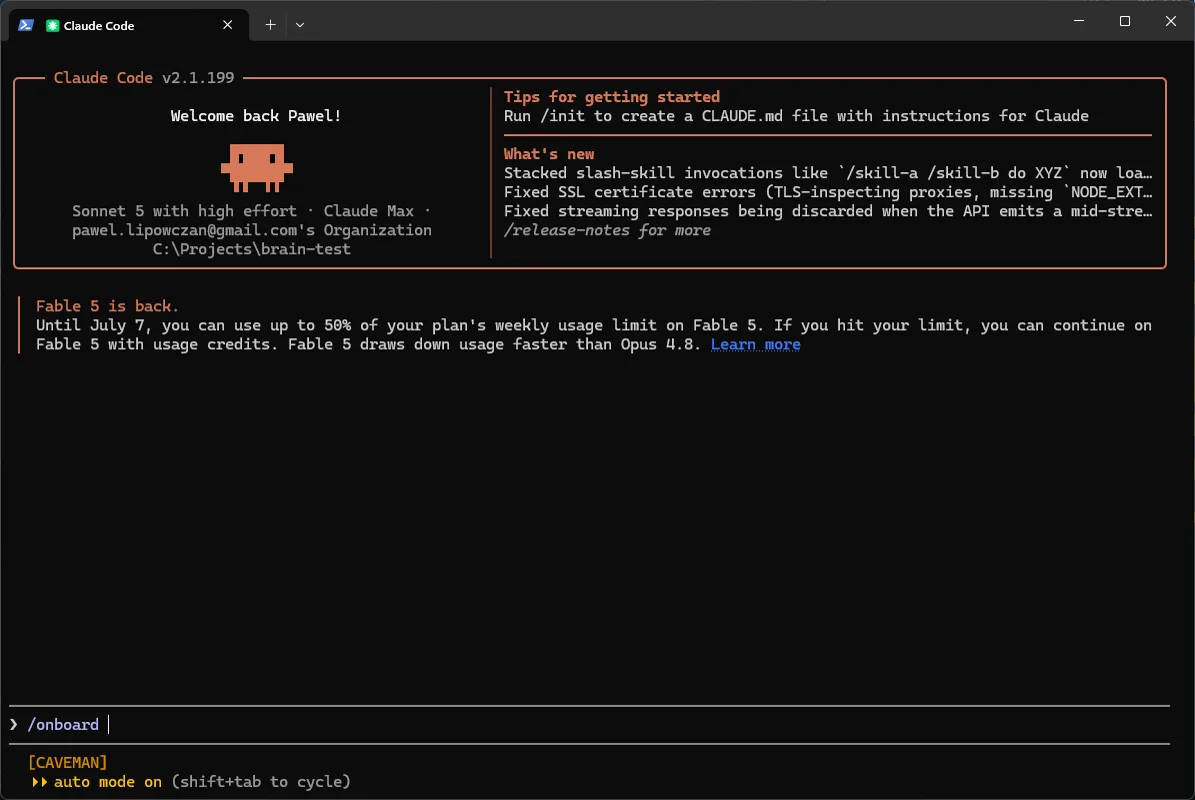
Jeśli CLAUDE.template.md już nie istnieje (baza była konfigurowana), kreator nie nadpisze niczego - zaproponuje ponowną konfigurację (patrz „Powtarzalność” niżej).
Jeśli pominiesz instalację, onboarding zatrzyma się na ostatnim kroku z błędem No module named 'yaml'. Szablony są już wtedy skasowane, więc nie zaczynaj od nowa: zainstaluj zależność i odpal /b:reindex.
Faza 1 - Wywiad (jedno pytanie na raz)
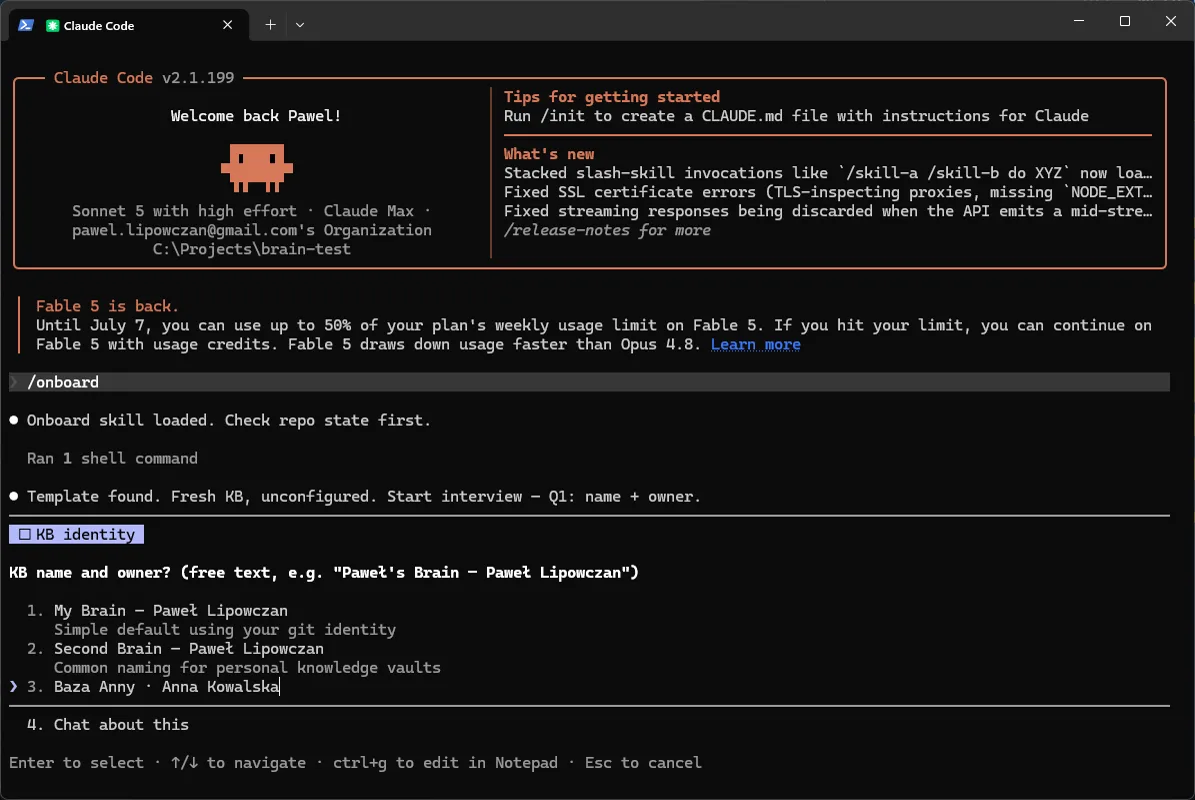
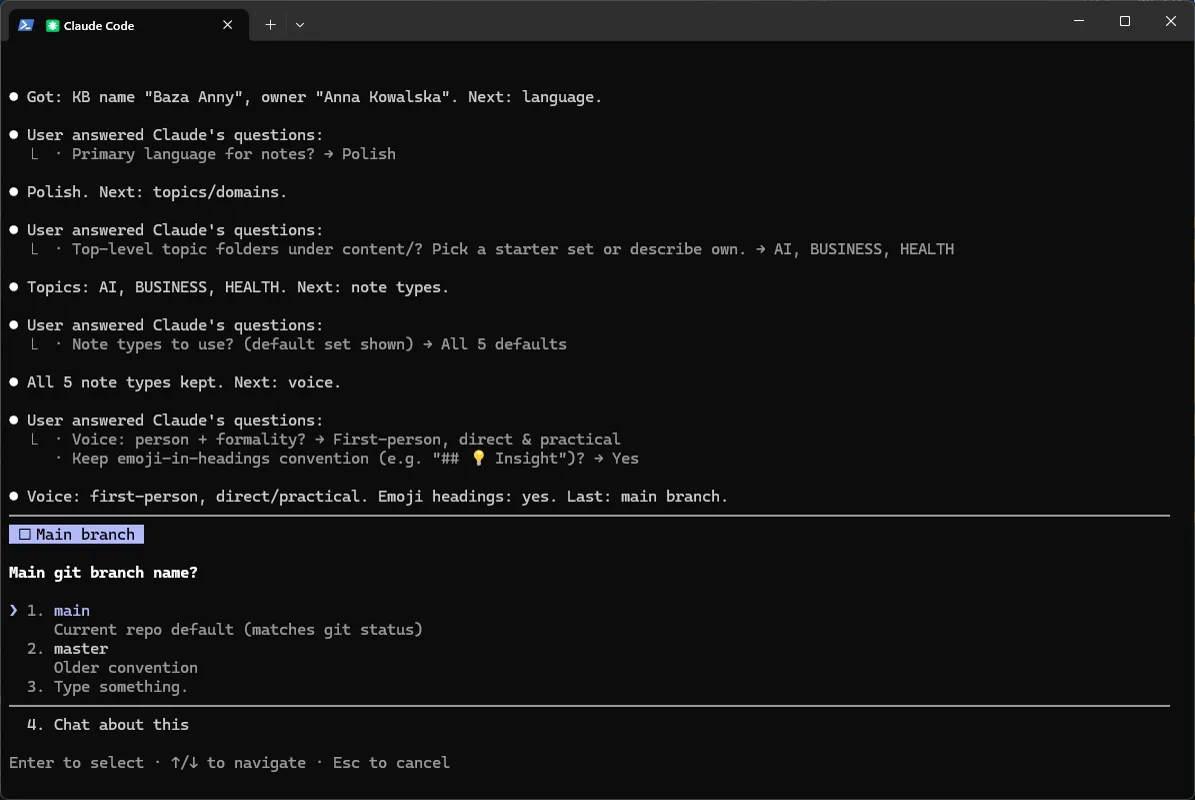
Kreator prowadzi sześć pytań, pojedynczo - wybierasz z gotowych opcji albo wpisujesz swoje. Po każdej odpowiedzi powtarza wybór i zapowiada następne pytanie, więc widzisz cały ślad decyzji. Poniżej realny przebieg „Bazy Anny”.
Q1 - Nazwa bazy i właściciel. Wolny tekst; kreator podpowiada warianty (np. z Twojej tożsamości git). Anna wpisuje Baza Anny · Anna Kowalska.
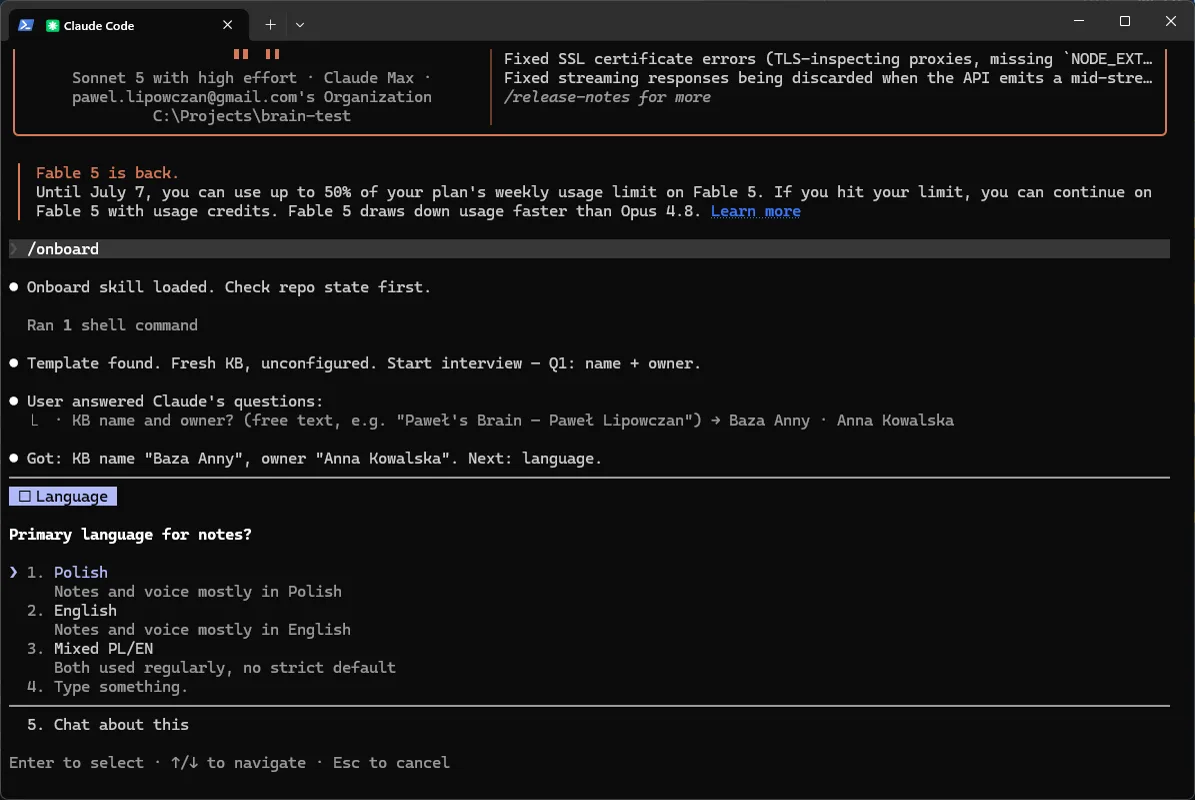
Q2 - Główny język. Język, w którym agent pisze noty i streszczenia. Anna: Polish.
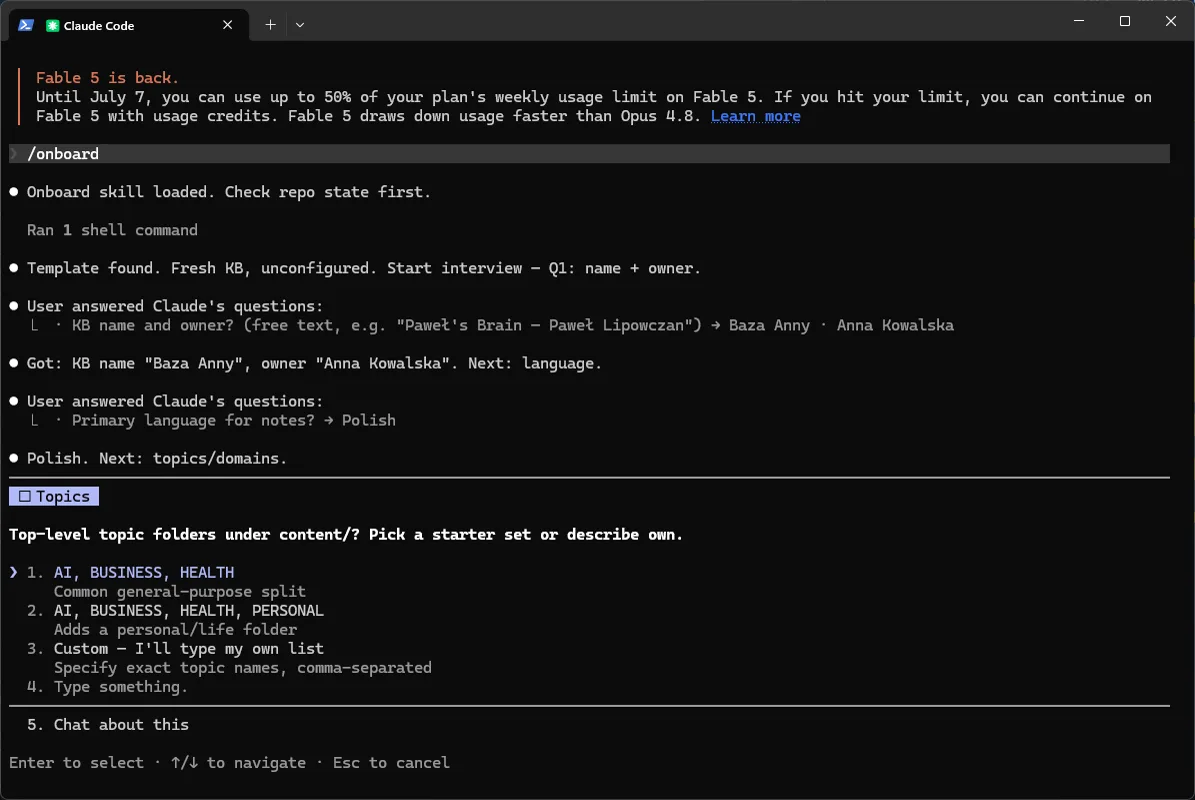
Q3 - Tematy / domeny. Foldery najwyższego poziomu pod content/ - szerokie działy, nie szczegóły. Kreator proponuje gotowe zestawy; Anna wybiera AI, BUSINESS, HEALTH.
Q4 - Typy not. Domyślnie 5: basic-note, knowledge-note, tool, book-note, answer-note. Anna zostawia wszystkie 5.
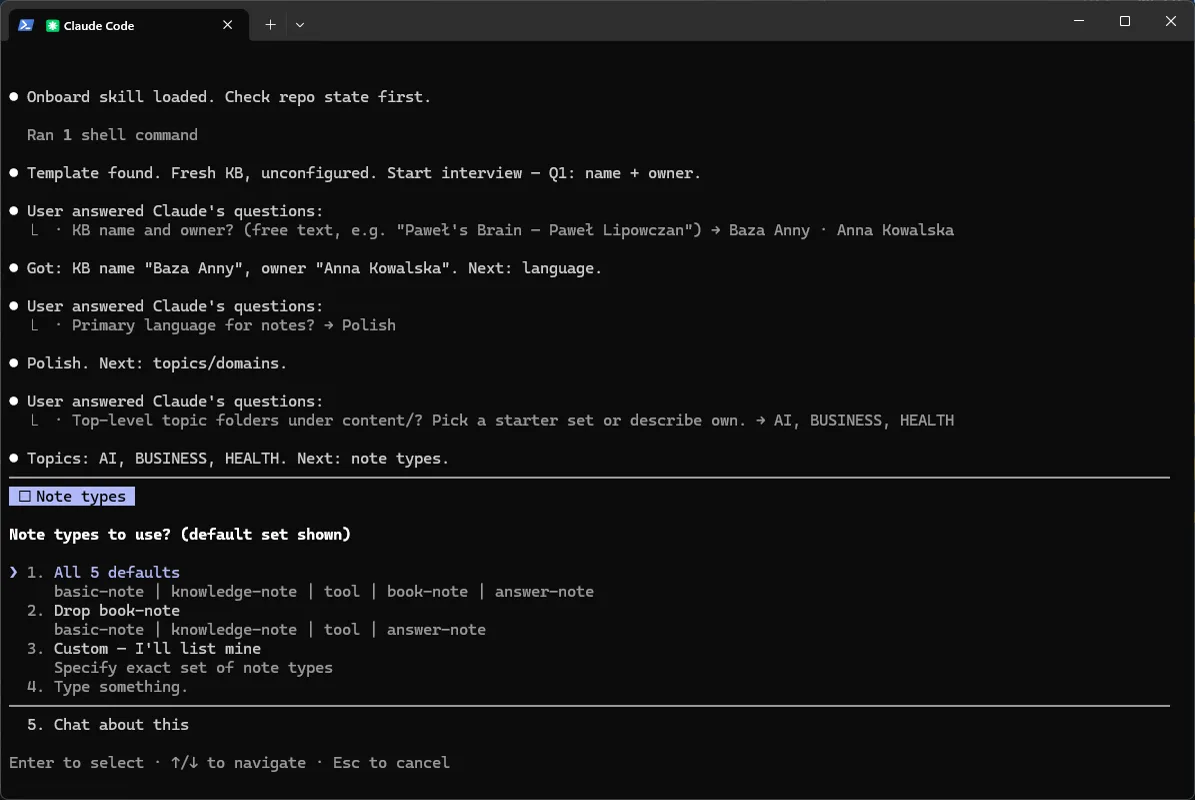
Q5 - Głos. Osoba + formalność. Anna: first-person, direct & practical („Notuję”, ton casual-professional).
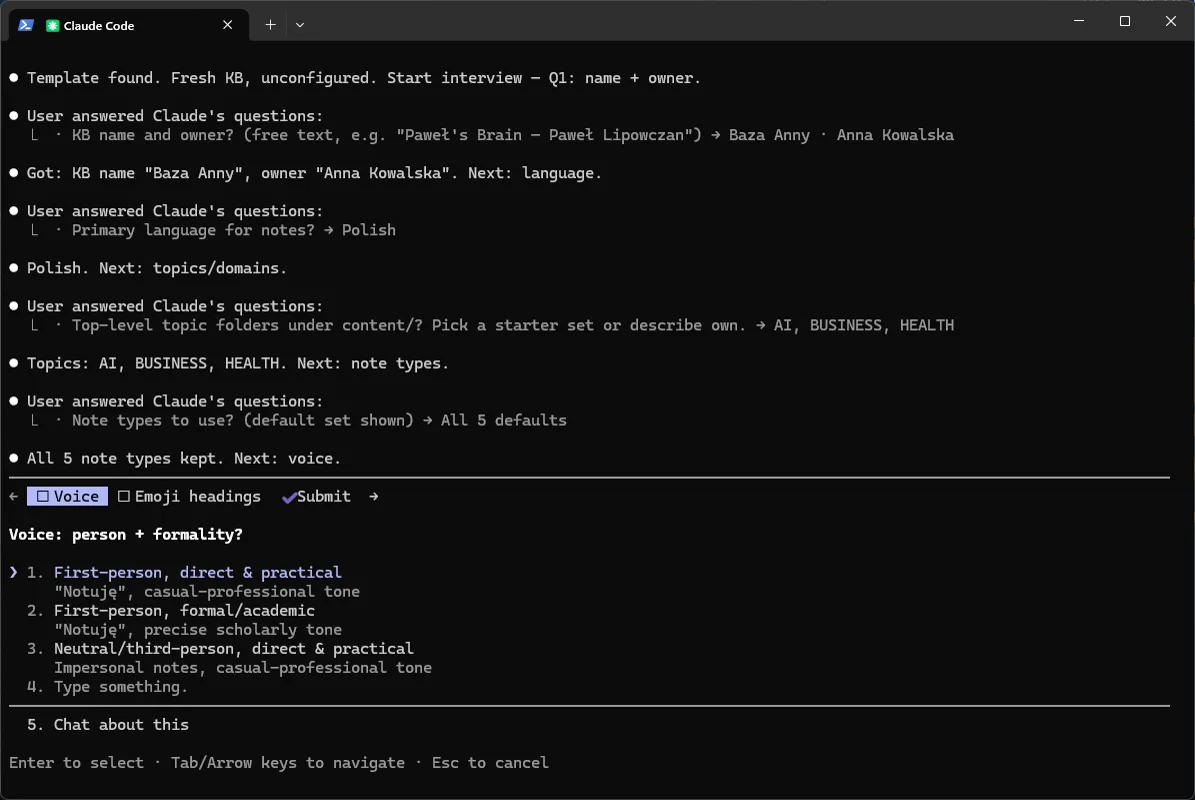
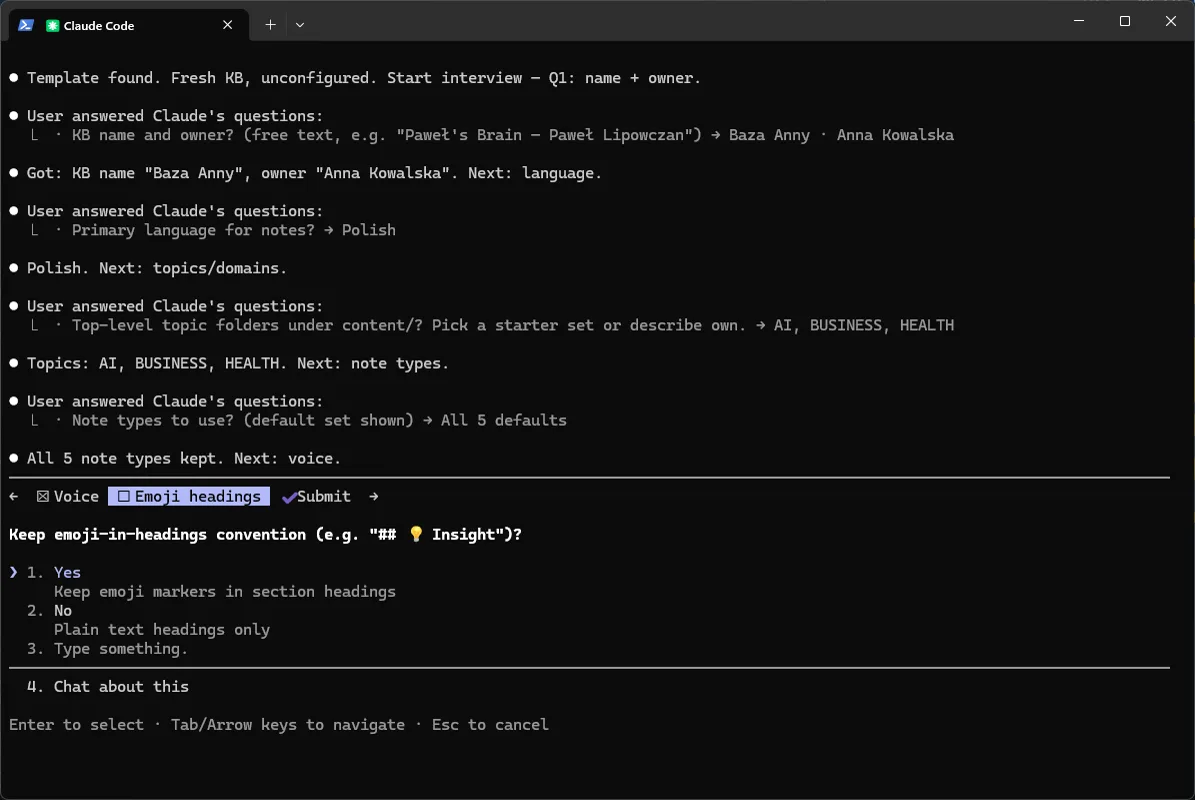
To samo pytanie ma drugą zakładkę - emoji w nagłówkach (## 💡 Insight). Anna zostawia Yes.
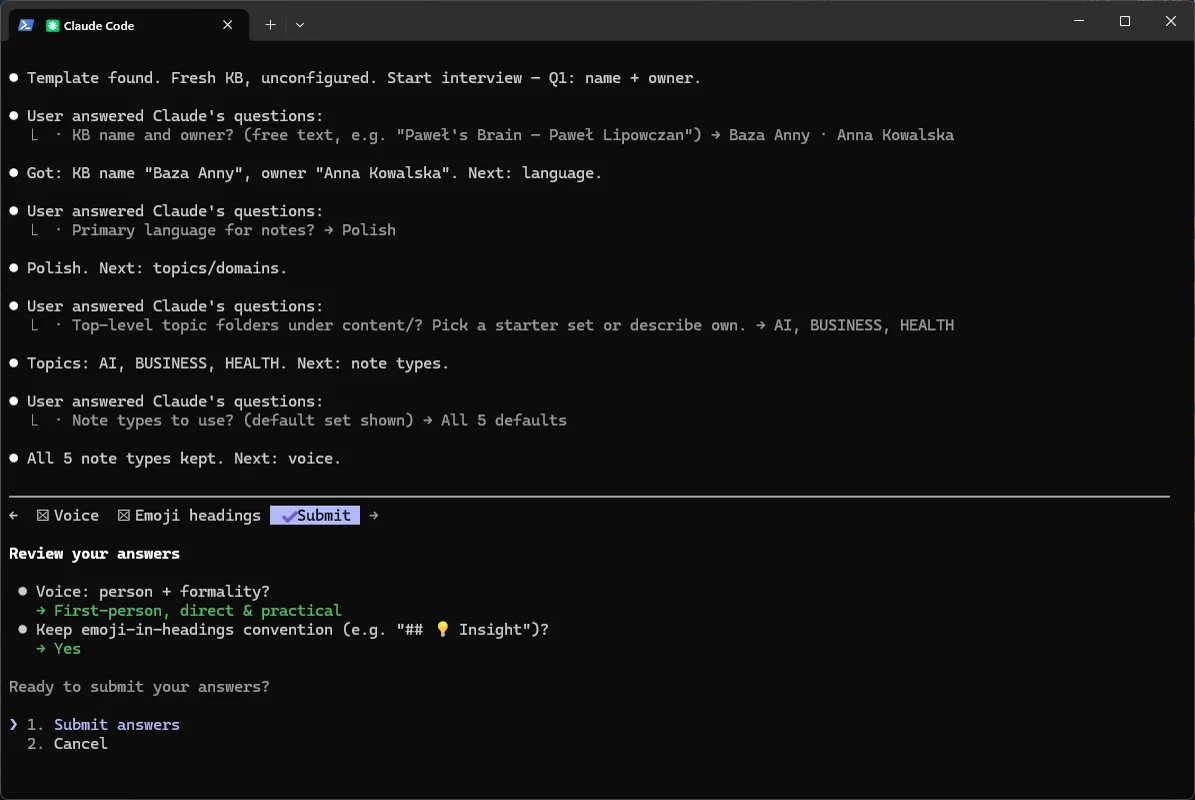
Głos + emoji zatwierdzasz razem - kreator pokazuje przegląd przed wysłaniem:
Q6 - Główna gałąź. Domyślnie main (pasuje do repo). Anna: main.
Faza 2 - Sprawdzenie narzędzi
Po ostatnim pytaniu kreator sprawdza, co masz na komputerze, i drukuje tabelę ✅/⚠️. Braki tylko zgłasza, niczego nie przerywa.
- Python - wymagany do
render.py,/b:reindexi/b:lint. - yt-dlp i ffmpeg - opcjonalne, pod
/b:ingestz YouTube.
Dla „Bazy Anny”: Python 3.13 ✅, yt-dlp ✅, ffmpeg ✅. Ta kontrola nie widzi PyYAML, dlatego instalujesz go przed startem.
Faza 3 - Generowanie (deterministyczne)
Potem kreator działa sam. Najpierw zapisuje odpowiedzi do .kb-onboard.json w korzeniu repo (to stąd bierze się jej powtarzalność):
{
  "KB_NAME": "Baza Anny",
  "KB_OWNER": "Anna Kowalska",
  "PRIMARY_LANGUAGE": "Polish",
  "MAIN_BRANCH": "main",
  "VOICE_PERSON": "first-person",
  "VOICE_FORMALITY": "direct and practical",
  "NOTE_TYPES": "basic-note | knowledge-note | tool | book-note | answer-note",
  "emoji_headings": true,
  "TOPIC_TABLE": "| `/content/AI/` | AI, agents, and tooling notes | Yes |\n| `/content/BUSINESS/` | Sales, marketing, operations notes | Yes |\n| `/content/HEALTH/` | Health, fitness, and wellbeing notes | Yes |"
}
Potem, krok po kroku:
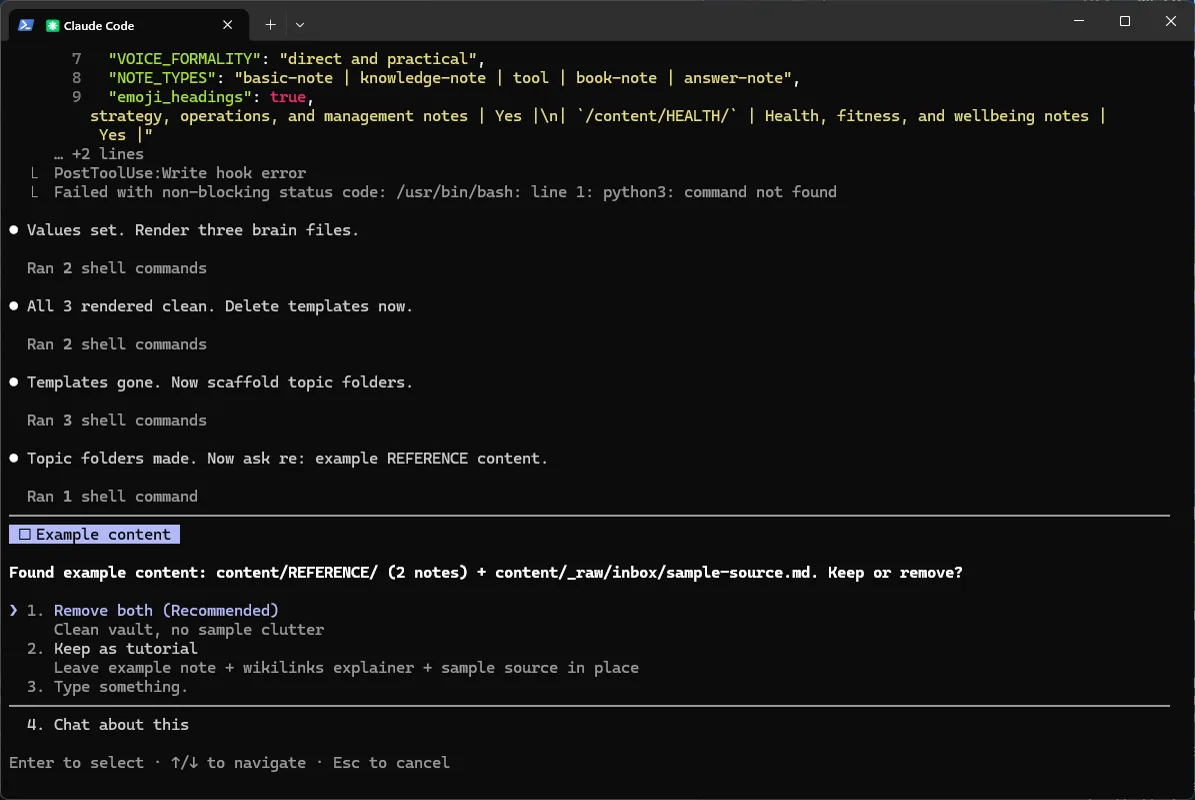
- Wypełnia trzy pliki schematu z szablonów (skrypt
render.py):CLAUDE.md,AGENTS.md,content/WRITING_STYLE.md. - Zapisuje stempel
.kb-template.json: wersję szablonu i odciski (krótkie sumy kontrolne) jego plików. Dzięki temu później da się odróżnić pliki szablonu od Twoich zmian. - Kasuje szablony (
*.template.md) - dopiero gdy wszystkie trzy pliki wygenerują się poprawnie. Razem z nimi usuwa pliki robocze szablonu:openspec/,dev/,CONTRIBUTING.md. - Tworzy foldery tematów pod
content/:AI/,BUSINESS/,HEALTH/. - Pyta o przykłady:
content/REFERENCE/(2 noty) +content/_raw/inbox/sample-source.md- usunąć czy zostawić jako samouczek. Anna wybiera „Keep as tutorial”. - Przycina szablony not do wybranych typów (tu wszystkie 5 zostają - nic nie ubywa).
- Przebudowuje indeksy (
build_indexes.py).
Faza 4 - Gotowe (podsumowanie + przekazanie)
Kreator drukuje podsumowanie: co powstało i co dalej.
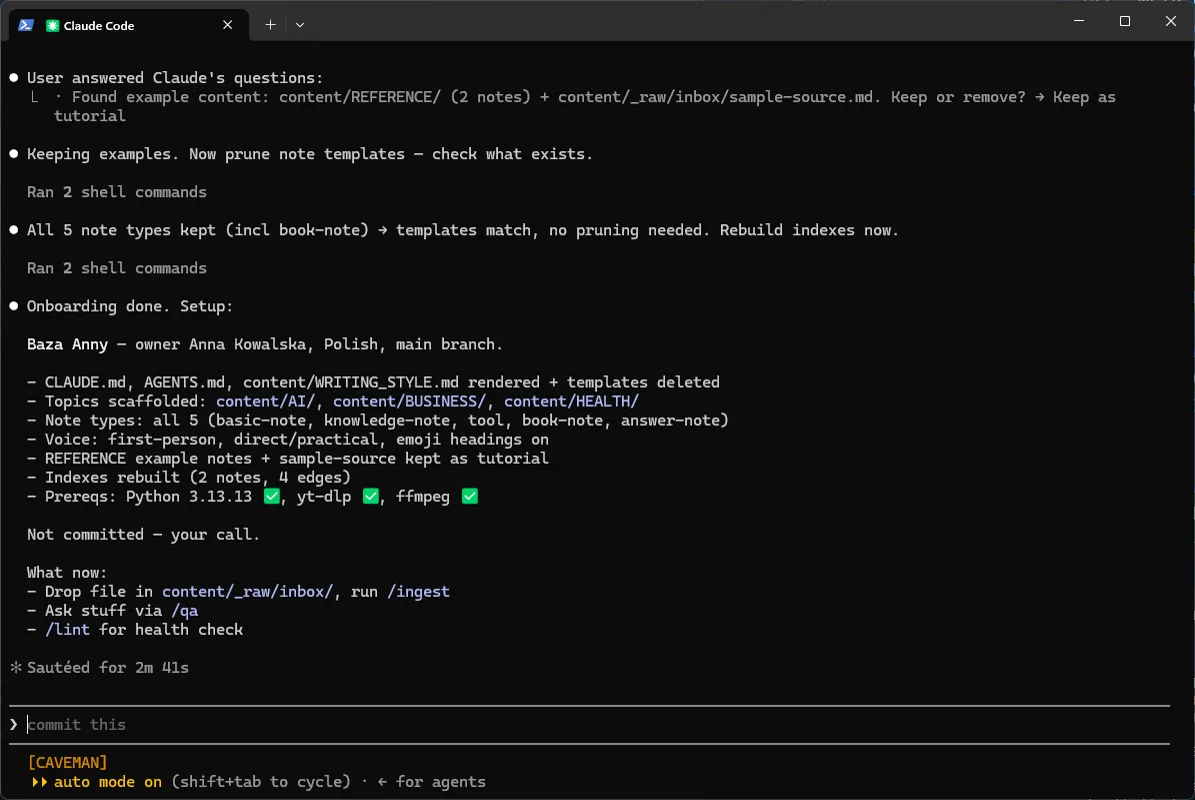
Dla „Bazy Anny” wyszło:
CLAUDE.md,AGENTS.md,content/WRITING_STYLE.mdwygenerowane, szablony i pliki robocze szablonu skasowane,.kb-onboard.jsoni.kb-template.jsonzapisane w korzeniu repo,- foldery tematów:
content/AI/,content/BUSINESS/,content/HEALTH/, - typy not: wszystkie 5; głos first-person direct/practical; emoji w nagłówkach: on,
REFERENCE/+sample-sourcezostawione jako samouczek,- indeksy przebudowane - 2 noty, 4 krawędzie (to te 2 przykładowe noty).
Repo po fazie:
content/
  AI/         .gitkeep
  BUSINESS/   .gitkeep
  HEALTH/     .gitkeep
  REFERENCE/  Example Note.md · Wikilinks Explained.md   (zostawione jako samouczek)
  _indexes/   vault-map.md · catalog.md · graph.md   (przebudowane: 2 noty, 4 krawędzie)
  templates/  (5 typów not)
CLAUDE.md                 ← wygenerowany (schema Twojej bazy)
AGENTS.md                 ← wygenerowany
content/WRITING_STYLE.md  ← wygenerowany (Twój głos)
.kb-onboard.json          ← Twoje odpowiedzi z wywiadu
.kb-template.json         ← stempel: wersja szablonu i odciski jego plików
Szablony *.template.md zniknęły - to znak, że baza jest zainicjalizowana. Zniknęły też openspec/, dev/ i CONTRIBUTING.md.
Co teraz (kreator podpowiada):
- wrzuć plik do
content/_raw/inbox/i odpal/b:ingest(lekcja 3), - zadaj pytanie przez
/b:qa(lekcja 4), - odpal
/b:lintna przegląd stanu bazy (lekcja 4).
Zapisz stan (git)
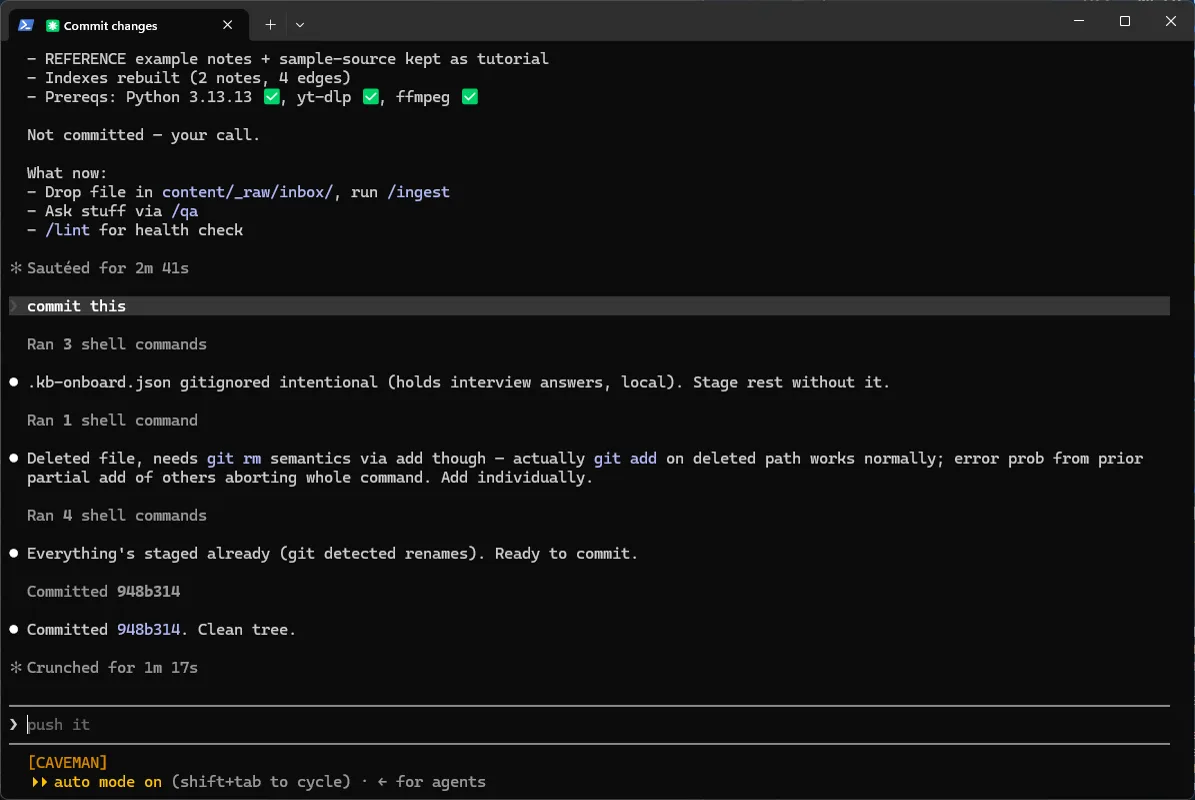
Baza to zwykłe repo git - pierwszy commit robisz jak zawsze. Możesz to nawet zlecić agentowi („commit this”): sam doda pliki i zrobi commit. Do commita idą też .kb-onboard.json i .kb-template.json, bo oba pliki jadą z bazą: pierwszy trzyma Twoje odpowiedzi, drugi wersję szablonu.
Powtarzalność
Odpowiedzi siedzą w .kb-onboard.json. Gdy odpalisz /b:onboard ponownie na już skonfigurowanej bazie (brak CLAUDE.template.md), kreator nie nadpisze niczego po cichu - zaproponuje ponowną konfigurację: wczyta .kb-onboard.json, pozwoli poprawić odpowiedzi i przegeneruje pliki, ostrzegając przed nadpisaniem istniejących.
🤖 Szybka ścieżka - onboarding promptem
/b:onboard prowadzi wywiad pytanie-po-pytaniu (jak wyżej). Jeśli wolisz, żeby Claude Code wykonał wszystko za jednym zamachem, wklej prompt z gotowymi odpowiedziami (podmień <...> na swoje):
Przeprowadź onboarding tej bazy (skill brain-onboard). Moje odpowiedzi:
- nazwa bazy / właściciel: <Baza Anny> / <Anna Kowalska>
- język: polski
- tematy: <AI>, <BUSINESS>, <HEALTH>
- typy not: domyślne
- głos: pierwsza osoba, praktyczny, emoji w nagłówkach: tak
- gałąź główna: main
- przykłady (content/REFERENCE/, sample-source.md): zostaw jako samouczek
Wykonaj wszystkie fazy: wygeneruj CLAUDE.md / AGENTS.md / WRITING_STYLE.md,
zapisz stempel .kb-template.json, skasuj szablony *.template.md i pliki robocze
szablonu, utwórz foldery tematów, przytnij szablony not do wybranych typów i
przebuduj indeksy. Na koniec pokaż drzewo repo i podsumowanie.
Efekt ten sam co wywiad - bez klikania. Odpowiedzi lądują w .kb-onboard.json, więc ponowna konfiguracja dalej działa.
Dzień zerowy
To Twój „dzień zerowy” - jedyny moment konfiguracji. Potem już tylko używasz: /b:ingest, /b:qa, /b:lint. Przechodzimy do karmienia bazy w lekcji 3.
FAQ
Ile razy odpalam /b:onboard?
Raz, na świeżym klonie. Kreator rozpoznaje świeży klon po obecności pliku CLAUDE.template.md. Jeśli odpalisz go ponownie na skonfigurowanej bazie (szablonu już nie ma), nie nadpisze niczego po cichu - zaproponuje ponowną konfigurację.
Co, jeśli wybiorę zły język albo tematy?
Poprawiasz przez ponowny /b:onboard w trybie ponownej konfiguracji: kreator wczyta Twoje odpowiedzi z .kb-onboard.json, pozwoli je zmienić i przegeneruje pliki, ostrzegając przed nadpisaniem. Foldery tematów to zwykłe katalogi pod content/ - nowe możesz dodać ręcznie w dowolnym momencie, a /b:reindex odświeży indeksy.
Gdzie zapisują się moje odpowiedzi z wywiadu?
W pliku .kb-onboard.json w korzeniu repo. Trafia do commita razem z resztą bazy, obok .kb-template.json. To z niego bierze się powtarzalność: ponowna konfiguracja czyta właśnie ten plik.
Dlaczego szablony *.template.md znikają po onboardingu?
Bo kreator wypełnia je Twoimi wartościami i zapisuje jako finalne pliki: CLAUDE.template.md → CLAUDE.md, AGENTS.template.md → AGENTS.md, content/WRITING_STYLE.template.md → content/WRITING_STYLE.md. Szablony kasuje dopiero gdy wszystkie trzy pliki wygenerują się poprawnie. Ich brak to znak, że baza jest zainicjalizowana.
Czy /b:onboard robi commit do gita?
Sprawdź po zakończeniu, czy zmiany czekają na zapis. Jeśli tak, zrób pierwszy commit sam albo zleć go agentowi („commit this”). .kb-onboard.json i .kb-template.json idą do commita razem z resztą, bo oba pliki jadą z bazą.
Czy do onboardingu potrzebuję Pythona?
Tak - kreator używa skryptów pythonowych (render.py do wygenerowania plików schemy, build_indexes.py do indeksów), a Python jest też wymagany później przez /b:reindex i /b:lint. Potrzebujesz też PyYAML (pip install -r requirements.txt): kontrola w Fazie 2 go nie widzi, więc bez niego onboarding stanie dopiero na ostatnim kroku. yt-dlp i ffmpeg są opcjonalne - przydają się dopiero przy /b:ingest z YouTube (lekcja 3).